ggplot(d) + geom_point(aes(x = age, y = heures.tv))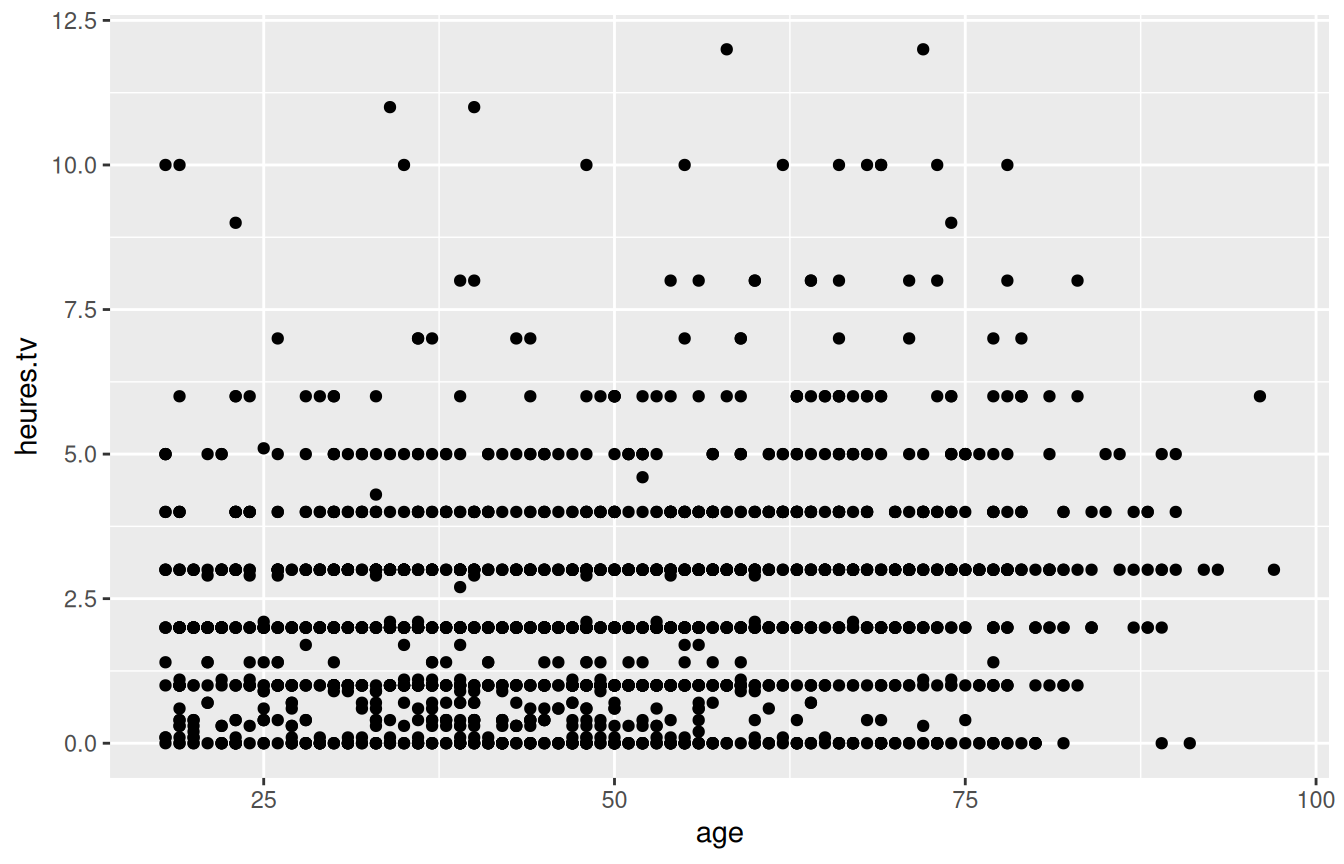
L3 économie-finance
Le code suivant représente l’âge et le nombre d’heures de télévision par jour des enquêtés de l’enquête Histoire de vie (d, comme dans les chapitres précédents). Regardez le graphique qu’il produit :
ggplot(d) + geom_point(aes(x = age, y = heures.tv))
Qu’est-ce que ce graphique cache, ou exagère ? Comment le corriger ? Écrivez votre réponse, puis le code du graphique corrigé, avant d’ouvrir la correction.
ggplot(d) + geom_jitter(aes(x = age, y = heures.tv), alpha = 0.15)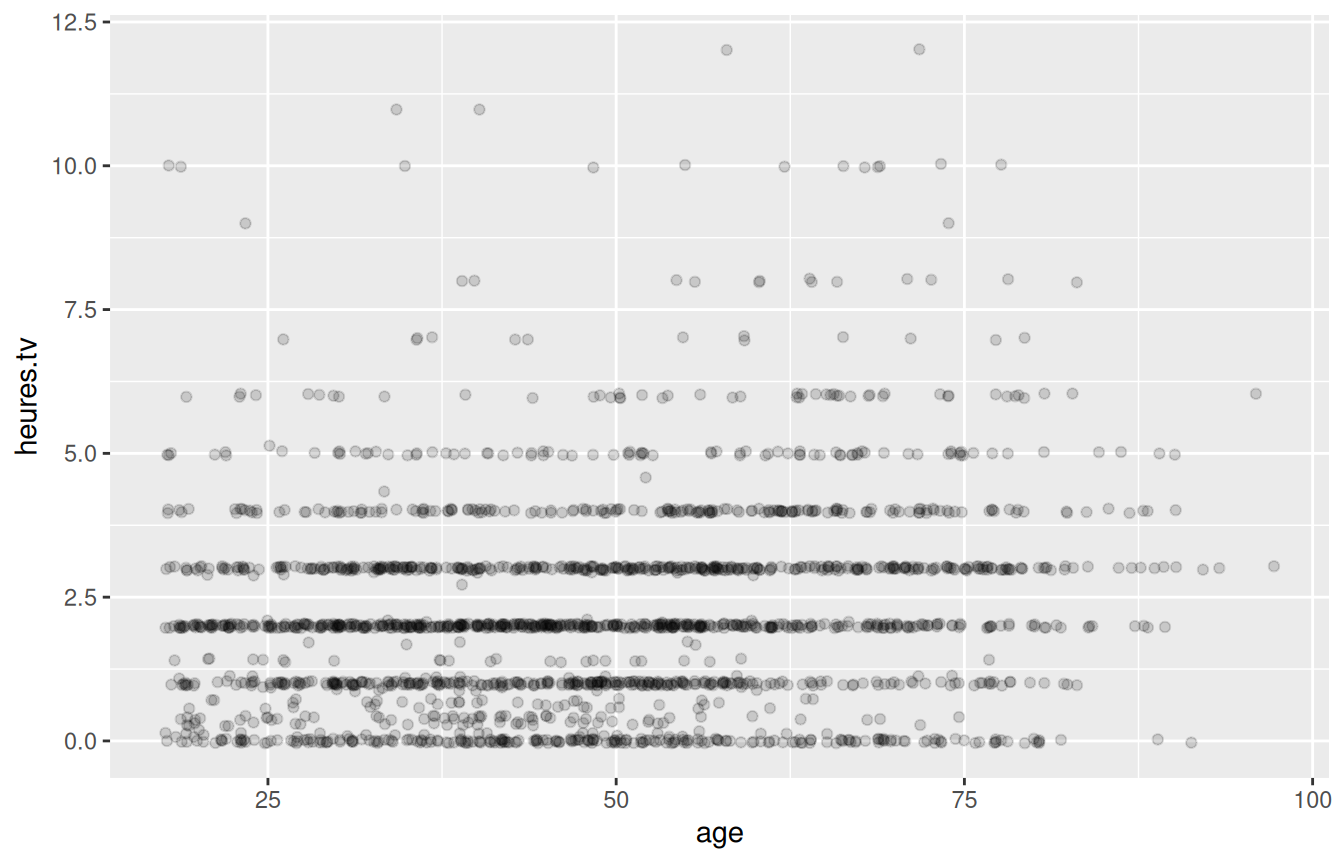
Les 2000 points sont opaques, et beaucoup se superposent exactement. Le premier graphique donne donc l’impression que les enquêtés sont répartis uniformément, alors qu’ils se concentrent dans certaines zones. geom_jitter() sépare les points superposés en les décalant légèrement, et la transparence (alpha) fait apparaître plus foncées les zones où ils s’accumulent.
Si vous n’aviez pas identifié le problème, relisez la partie « Croiser deux variables » du chapitre 4.
Ce dernier chapitre est consacré à un projet personnel : une analyse complète de l’enquête Histoire de vie, qui mobilise tout ce que vous avez appris.
Vous rendrez un script R commenté qui répond à deux ou trois questions de votre choix sur ces données. Pour chaque question, le script doit contenir :
Cette page rappelle d’abord les outils à votre disposition, puis vous guide pour choisir vos questions, écrire le script et le rendre.
| Fonction | Ce qu’elle fait |
|---|---|
select() |
choisit des colonnes |
filter() |
choisit des lignes |
arrange() |
trie les lignes |
mutate() |
crée ou modifie une colonne |
d |>
  filter(age < 30) |>
  select(age, sexe, qualif) |>
  arrange(age)
Voir le chapitre 2.
| Fonction | Ce qu’elle fait |
|---|---|
summarise() |
calcule des indicateurs |
count() |
compte les modalités |
group_by() |
découpe en groupes |
n() |
donne l’effectif du groupe |
d |>
  group_by(qualif) |>
  summarise(
    effectif = n(),
    age_moyen = mean(age)
  ) |>
  arrange(desc(age_moyen))
Voir le chapitre 3.
| Géométrie | Pour quoi |
|---|---|
geom_histogram() |
distribution d’une variable quantitative |
geom_bar() |
effectifs d’une variable qualitative |
geom_point(), geom_jitter() |
deux variables quantitatives |
geom_boxplot() |
une quantitative selon une qualitative |
facet_wrap() |
le même graphique par groupe |
ggplot(d) +
  geom_boxplot(aes(x = heures.tv, y = qualif)) +
  labs(x = "Heures de télévision par jour", y = NULL)
Voir le chapitre 4.
Le choix des questions est l’étape la plus importante du projet. Une bonne question remplit trois conditions :
glimpse(d)) ;Quelques exemples :
| Trop vague | Utilisable |
|---|---|
| « Étudier les loisirs » | « Les cadres lisent-ils plus de bandes dessinées que les ouvriers ? » |
| « Analyser la télévision » | « Le temps passé devant la télévision diminue-t-il avec le niveau d’études ? » |
| « Voir les différences hommes-femmes » | « À âge et qualification comparables, les femmes déclarent-elles moins pratiquer un sport ? » |
Voici quelques pistes :
clso) varie-t-il selon la qualification ?relig) ?trav.imp) ? Et qui en est satisfait (trav.satisf) ?cuisine, bricol, peche.chasse, cinema) se répartissent-elles différemment selon le sexe ?Prenez-en une, et posez-vous ensuite la question qui vient naturellement après.
Écrivez vos deux ou trois questions en français, dans votre script, avant d’écrire la moindre ligne de code.
Sinon, vous produirez des calculs sans savoir ce que vous cherchez, et vous ne pourrez pas dire si le résultat est bon.
Votre script doit suivre la structure suivante :
# Projet M3P — Prénom Nom — numéro d'étudiant
# Analyse de l'enquête Histoire de vie 2003

# Préparation ------------------------------------------------

library(tidyverse)
library(questionr)

data(hdv2003)
d <- as_tibble(hdv2003)


# Question 1 : les cadres regardent-ils moins la télévision ? ----

# ...


# Question 2 : ... ----

# ...Un commentaire terminé par au moins quatre tirets crée une section :
# Question 1 : la pratique sportive selon l'âge ----RStudio affiche alors un plan du script, qui permet de passer d’une section à l’autre. Ctrl + Shift + O affiche ou masque ce plan. Les sections ne changent rien à l’exécution : ce sont des commentaires ordinaires.
Faites une section par question. C’est ce qui rend un script lisible, pour moi qui le corrigerai, et pour vous quand vous le relirez dans trois semaines.
Commentez ce que vous cherchez et ce que vous trouvez, pas ce que fait la ligne :
# Inutile
# calcule la moyenne
mean(d$age)

# Utile
# On écarte les 5 non-répondants sur les heures de télévision.
# La moyenne porte donc sur 1995 personnes.
d |> summarise(
  effectif = sum(!is.na(heures.tv)),
  moyenne = mean(heures.tv, na.rm = TRUE)
)Quatre réflexes, vus au fil des chapitres, font la différence entre un script qui tourne et une analyse juste :
heures.tv n’est pas un titre d’axe.Ctrl + Shift + F10, puis exécutez le script en entier (Ctrl + Shift + Entrée). Il doit tourner sans erreur dans une session vierge : c’est la seule façon de vérifier qu’il ne dépend pas d’un objet que vous avez créé dans la console et oublié.?nom_de_la_fonction, et regardez la rubrique Examples, tout en bas.|> un à un, pour voir à quelle étape le résultat cesse d’être celui que vous attendez.Le point 3 est le plus efficace.
Un fichier .R, nommé Nom_Prenom.R, à déposer sur Moodle.
Il doit :
| Critère | Ce que je regarde |
|---|---|
| Le script tourne | exécution complète sans erreur |
| Questions | posées explicitement, précises |
| Pertinence | le calcul répond bien à la question posée |
| Prudence | effectifs affichés, valeurs manquantes traitées |
| Graphiques | lisibles, axes nommés |
| Lecture | une phrase de commentaire par résultat |
Deux questions bien traitées valent mieux que cinq survolées.
RStudio sait transformer un script en document, sans rien apprendre de nouveau : les lignes qui commencent par #' sont interprétées comme du texte.
#' # Analyse de la pratique sportive
#'
#' On commence par regarder la répartition par sexe.

d |> count(sport, sexe)
Ctrl + Shift + K produit alors un document HTML qui mêle texte, code et résultats.
C’est facultatif, et cela ne rapporte rien de plus. Mais si le mécanisme vous intéresse, c’est le point d’entrée vers Quarto et les documents reproductibles.
Vous savez maintenant charger des données, les décrire, les représenter, et rendre un travail reproductible.
Vous retrouverez ces outils en économétrie, en séries temporelles et dans votre projet tutoré. Les leçons swirl facultatives restent disponibles si vous voulez aller plus loin : conditions, boucles, écriture de fonctions, tirages aléatoires… La liste complète est dans LECONS_OPTIONNELLES.md. Le manuel de Julien Barnier, Introduction à R et au tidyverse, couvre largement ce que nous n’avons pas eu le temps d’aborder.
Et si vous vous faites aider par un assistant IA, vous avez désormais de quoi juger ce qu’il vous répond.